随着企业数据规模的快速增长,传统物理机或虚拟机部署Apache DolphinScheduler面临着环境配置复杂、资源利用率低、扩展性差等痛点。特别是在需要运行Spark等大数据计算任务时,手动维护多套环境、处理依赖冲突、应对突发流量等问题更是让运维团队疲于奔命。
Kubernetes云原生部署为这些问题提供了优雅的解决方案——通过容器化实现环境一致性,利用共享存储解决Spark等二进制文件的分发难题,配合自动扩缩容实现资源的弹性利用。
为此,本文将深入探讨在Kubernetes环境中部署Apache DolphinScheduler并集成Spark作业的完整实践,帮助你从零构建一个高可用、易扩展的云原生调度平台。
前置要求
- 存储类支持ReadWriteMany访问模式(用于共享存储)
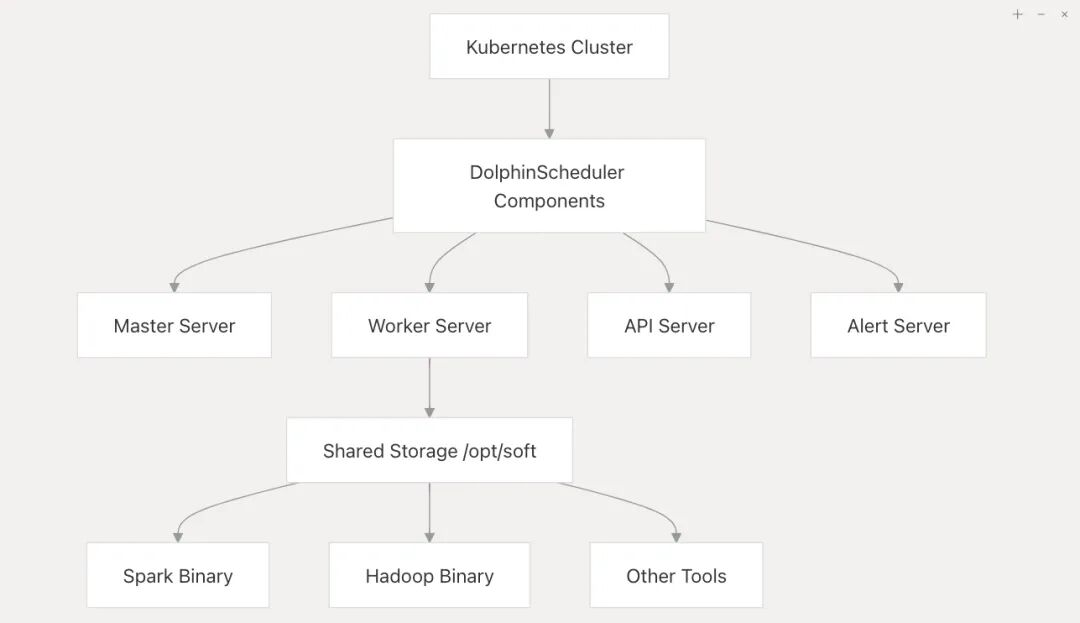
部署架构
1. 添加Helm仓库
helm repo add dolphinscheduler https://dolphinscheduler.apache.org/helmhelm repo update
2. 创建命名空间
kubectl create namespace dolphinscheduler
3. 配置values.yaml
创建自定义的values.yaml文件,关键配置如下:
# 共享存储配置 - 关键配置,用于存储Spark等二进制文件common: sharedStoragePersistence: enabled: true # 必须启用以支持Spark mountPath: "/opt/soft" accessModes: - "ReadWriteMany" storageClassName: "your-storage-class" # 替换为实际的存储类 storage: "20Gi" configmap: # Spark环境变量配置 SPARK_HOME: "/opt/soft/spark" HADOOP_HOME: "/opt/soft/hadoop" HADOOP_CONF_DIR: "/opt/soft/hadoop/etc/hadoop" JAVA_HOME: "/opt/java/openjdk"# 数据库配置(使用外部数据库)externalDatabase: enabled: true host: "your-mysql-host" port: "3306" database: "dolphinscheduler" username: "root" password: "your-password" type: "mysql"# Worker配置worker: replicas: 2 env: WORKER_EXEC_THREADS: "10"
4. 部署DolphinScheduler
helm install dolphinscheduler dolphinscheduler/dolphinscheduler \ --namespace dolphinscheduler \ --values values.yaml \ --version 3.2.0 # 使用具体版本号
5. 验证部署状态
# 查看Pod状态kubectl get pods -n dolphinscheduler# 查看服务kubectl get svc -n dolphinscheduler# 查看PVC状态kubectl get pvc -n dolphinscheduler
1. 下载Spark二进制包
# 下载Spark 3.2.1为例wget https://archive.apache.org/dist/spark/spark-3.2.1/spark-3.2.1-bin-hadoop2.7.tgz
2. 复制到Worker容器
由于共享存储已挂载到/opt/soft,只需复制到一个Worker Pod即可:
# 复制Spark二进制包到容器kubectl cp spark-3.2.1-bin-hadoop2.7.tgz dolphinscheduler-worker-0:/opt/soft -n dolphinscheduler# 进入容器解压kubectl exec -it dolphinscheduler-worker-0 -n dolphinscheduler bashcd /opt/softtar zxf spark-3.2.1-bin-hadoop2.7.tgzrm -f spark-3.2.1-bin-hadoop2.7.tgzln -s spark-3.2.1-bin-hadoop2.7 spark# 验证Spark安装$SPARK_HOME/bin/spark-submit --version
3. 配置Hadoop(如需Spark on YARN)
如果需要使用Spark on YARN模式,还需要配置Hadoop:
# 下载Hadoop二进制包wget https://archive.apache.org/dist/hadoop/common/hadoop-3.3.1/hadoop-3.3.1.tar.gz# 复制到容器kubectl cp hadoop-3.3.1.tar.gz dolphinscheduler-worker-0:/opt/soft -n dolphinscheduler# 解压配置kubectl exec -it dolphinscheduler-worker-0 -n dolphinscheduler bashcd /opt/softtar zxf hadoop-3.3.1.tar.gzrm -f hadoop-3.3.1.tar.gzln -s hadoop-3.3.1 hadoop# 配置Hadoop环境变量(已在values.yaml中配置)export HADOOP_HOME=/opt/soft/hadoopexport HADOOP_CONF_DIR=/opt/soft/hadoop/etc/hadoop
1. Shell任务验证
首先通过Shell任务验证Spark环境:
在DolphinScheduler Web UI中创建Shell任务:
$SPARK_HOME/bin/spark-submit --class org.apache.spark.examples.SparkPi \ $SPARK_HOME/examples/jars/spark-examples_2.12-3.2.1.jar
检查任务日志是否包含输出Pi is roughly 3.14...。
2. Spark任务验证
上传资源文件
- 在DolphinScheduler资源中心上传
spark-examples_2.12-3.2.1.jar
程序类型:Java
主函数的Class:
org.apache.spark.examples.SparkPi主程序包:
spark-examples_2.12-3.2.1.jar部署方式:local
Master:local[*]
Spark SQL任务验证
创建Spark SQL任务:
-- 创建测试表CREATE TABLE IF NOT EXISTS test_table ( id INT, name STRING) USING parquet;-- 插入测试数据INSERT INTO test_table VALUES (1, 'test'), (2, 'dolphinscheduler');-- 查询数据SELECT * FROM test_table;
配置参数:
程序类型:SQL
部署方式:local
Master:local[*]
根据DolphinScheduler文档,当前Kubernetes部署中对不同Spark模式的支持情况:
| | |
|---|
| | |
| | |
| Spark-Standalone(cluster) | | |
| Spark-Kubernetes(cluster) | | |
1. 自定义Worker镜像
如果需要预装Spark,可以构建自定义Worker镜像:
FROM dolphinscheduler.docker.scarf.sh/apache/dolphinscheduler-worker:3.2.0# 安装SparkRUN wget https://archive.apache.org/dist/spark/spark-3.2.1/spark-3.2.1-bin-hadoop2.7.tgz && \ tar zxf spark-3.2.1-bin-hadoop2.7.tgz -C /opt/soft && \ rm -f spark-3.2.1-bin-hadoop2.7.tgz && \ ln -s /opt/soft/spark-3.2.1-bin-hadoop2.7 /opt/soft/spark# 设置环境变量ENV SPARK_HOME=/opt/soft/spark
构建并推送镜像:
docker build -t your-registry/dolphinscheduler-worker:spark .docker push your-registry/dolphinscheduler-worker:spark
修改values.yaml:
worker: image: repository: your-registry/dolphinscheduler-worker tag: spark
2. 资源限制配置
为Worker配置资源限制:
worker: resources: limits: memory: "8Gi" cpu: "4" requests: memory: "4Gi" cpu: "2"
3. Worker自动扩缩容
DolphinScheduler支持基于KEDA的Worker自动扩缩容:
# 安装KEDAkubectl create namespace kedahelm install keda kedacore/keda --namespace keda --version v2.0.0# 启用Worker自动扩缩容helm upgrade dolphinscheduler dolphinscheduler/dolphinscheduler \ --namespace dolphinscheduler \ --set worker.keda.enabled=true \ --set worker.keda.minReplicaCount=1 \ --set worker.keda.maxReplicaCount=10
1. 查看Pod日志
# 查看Worker日志kubectl logs dolphinscheduler-worker-0 -n dolphinscheduler -f# 查看特定任务日志kubectl logs dolphinscheduler-worker-0 -n dolphinscheduler | grep "task"
2. 验证共享存储
# 检查PVC状态kubectl get pvc -n dolphinscheduler# 进入容器验证挂载kubectl exec -it dolphinscheduler-worker-0 -n dolphinscheduler bashdf -h | grep opt/softls -la /opt/soft
3. 验证环境变量
kubectl exec -it dolphinscheduler-worker-0 -n dolphinscheduler bashecho $SPARK_HOMEecho $HADOOP_HOME$SPARK_HOME/bin/spark-submit --version
4. 常见问题
问题1:Spark命令找不到
- 验证Spark二进制文件是否正确解压到
/opt/soft
问题2:共享存储无法挂载
问题3:Spark on YARN失败
- 验证
HADOOP_CONF_DIR指向正确的配置目录
存储配置:使用高性能存储类(如SSD)作为共享存储,提升Spark作业性能
资源配额:为Worker设置合理的资源限制,避免资源争抢
监控告警:配置Pod和作业级别的监控告警
高可用:Master和Worker至少配置2个副本
备份策略:定期备份数据库和资源文件
本文基于Apache DolphinScheduler 3.2.0版本编写,不同版本可能存在配置差异。Spark-Kubernetes(cluster)原生模式在当前版本中尚不支持,如需此功能需等待后续版本更新。实际部署时请根据具体环境调整配置参数,特别是存储类、数据库连接等环境相关配置。
- GitHub: https://github.com/apache/dolphinscheduler
- 官网:https://dolphinscheduler.apache.org/en-us
- 订阅开发者邮件:dev@dolphinscheduler@apache.org(向邮箱发送任意内容,收到邮件后回复同意订阅即可)
- YouTube:https://www.youtube.com/@apachedolphinscheduler
- Slack:https://join.slack.com/t/asf-dolphinscheduler/shared_invite/zt-1cmrxsio1-nJHxRJa44jfkrNL_Nsy9Qg
同样地,参与Apache DolphinScheduler 有非常多的参与贡献的方式,主要分为代码方式和非代码方式两种。
非代码方式包括:
完善文档、翻译文档;翻译技术性、实践性文章;投稿实践性、原理性文章;成为布道师;社区管理、答疑;会议分享;测试反馈;用户反馈等。
代码方式包括:
查找Bug;编写修复代码;开发新功能;提交代码贡献;参与代码审查等。
贡献第一个PR(文档、代码) 我们也希望是简单的,第一个PR用于熟悉提交的流程和社区协作以及感受社区的友好度。社区汇总了以下适合新手的问题列表:https://github.com/apache/dolphinscheduler/pulls?q=is%3Apr+is%3Aopen+label%3A%22first+time+contributor%22优先级问题列表:https://github.com/apache/dolphinscheduler/pulls?q=is%3Apr+is%3Aopen+label%3Apriority%3Ahigh如何参与贡献链接:https://dolphinscheduler.apache.org/zh-cn/docs/3.2.2/%E8%B4%A1%E7%8C%AE%E6%8C%87%E5%8D%97_menu/%E5%A6%82%E4%BD%95%E5%8F%82%E4%B8%8E_menuhttps://github.com/apache/dolphinscheduler